LLM Nedir? Hugging Face ve Unsloth kullanarak Fine-Tuning ile Model ve Dataset Oluşturma
1. Giriş
1.1 LLM (Large Language Model) Nedir?
Merhaba! Bu yazıda, son zamanlarda yapay zekâ ve doğal dil işleme (NLP) alanında sıkça duyduğumuz "Büyük Dil Modelleri" yani LLM'lerin ne olduğuna yakından bakacağız. Kısaca anlatmak gerekirse, LLM'ler son derece büyük veri setleri üzerinde eğitilen ve insanların konuşma veya yazı diline oldukça benzer metinler üretebilen modellerdir. Özellikle 2017'de tanıtılan Transformer mimarisi bu alanda çığır açmış, GPT, BERT ve LLaMA gibi modellerin yükselişini sağlamıştır.
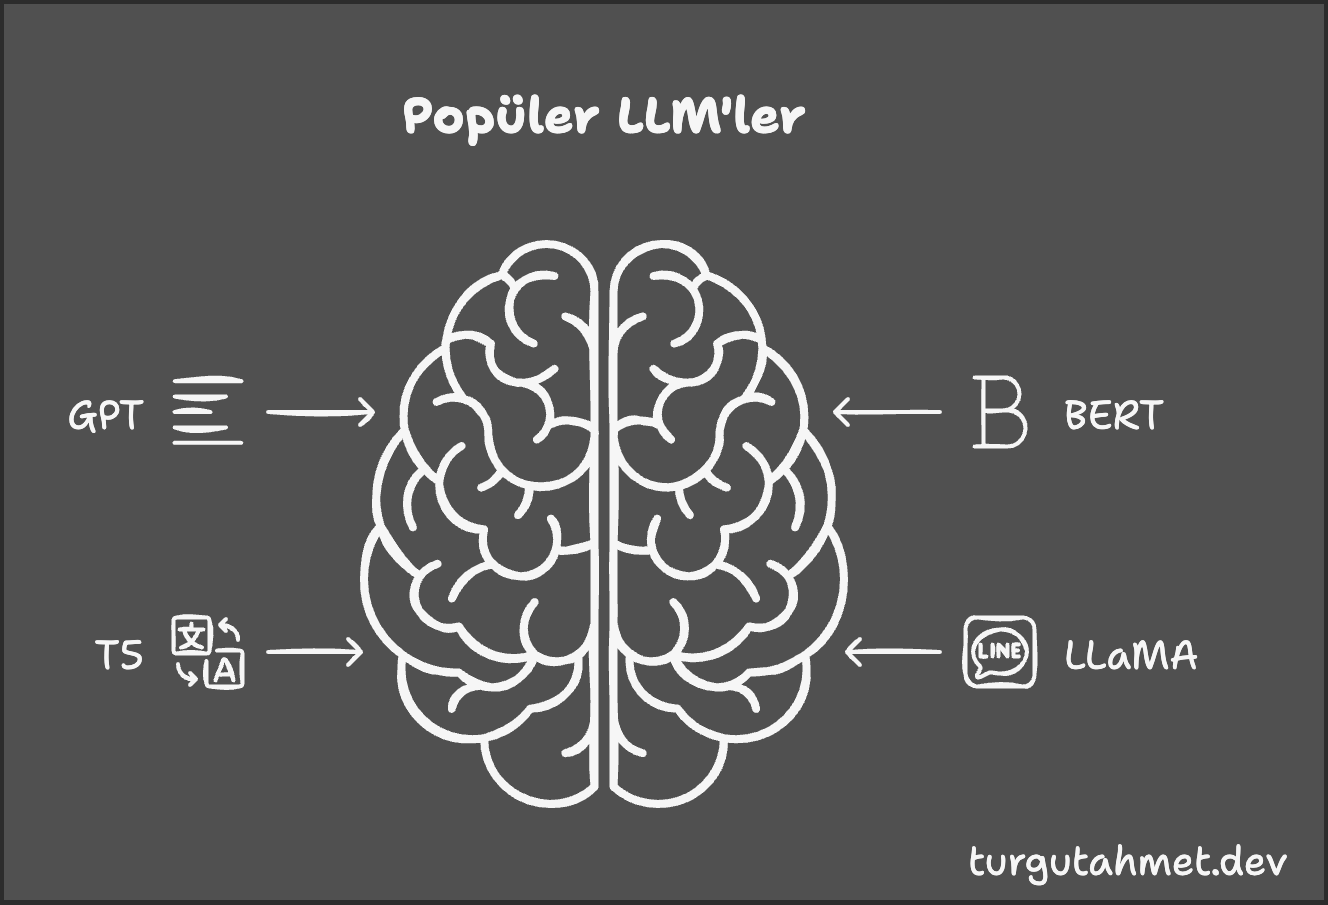
| Model | Mimarisi | Kullanım Alanı | Öne Çıkan Özellik |
|---|---|---|---|
| GPT | Decoder-only | Metin üretimi, tamamlama | Büyük ölçekli metin üretimi |
| BERT | Encoder-only | Metin anlama, sınıflandırma | Çift yönlü bağlam analizi |
| T5 | Encoder-Decoder | Metin-çeviri, özetleme | Tüm görevler için metin-çeviri formatı |
| LLaMA | Decoder-only | Genel amaçlı NLP görevleri | Açık kaynak, düşük kaynak tüketimi |
Günümüzde LLM'ler; tıptan hukuka, eğitimden müşteri hizmetlerine kadar çok geniş bir yelpazede kullanılmaktadır. Örneğin, doktorlara tıbbi belgeleri özetleme konusunda yardımcı olabilir, yasal metinleri analiz edebilir veya sohbet botlarıyla etkileşimi daha doğal ve akıcı hale getirebilirler.
1.2 LLM'ler Nasıl Eğitilir?
"Peki bu kocaman modeller nasıl eğitiliyor?" diye merak ediyor olabilirsiniz. Aslında süreç, veri toplamaktan başlayıp modelin mimarisini oluşturmaya, eğitim döngüsünden değerlendirme adımlarına kadar uzanan standart ama zahmetli bir yolculuğu içerir. Şimdi adım adım bakalım.
1.2.1 Veri Hazırlığı (Data Collection & Preprocessing)
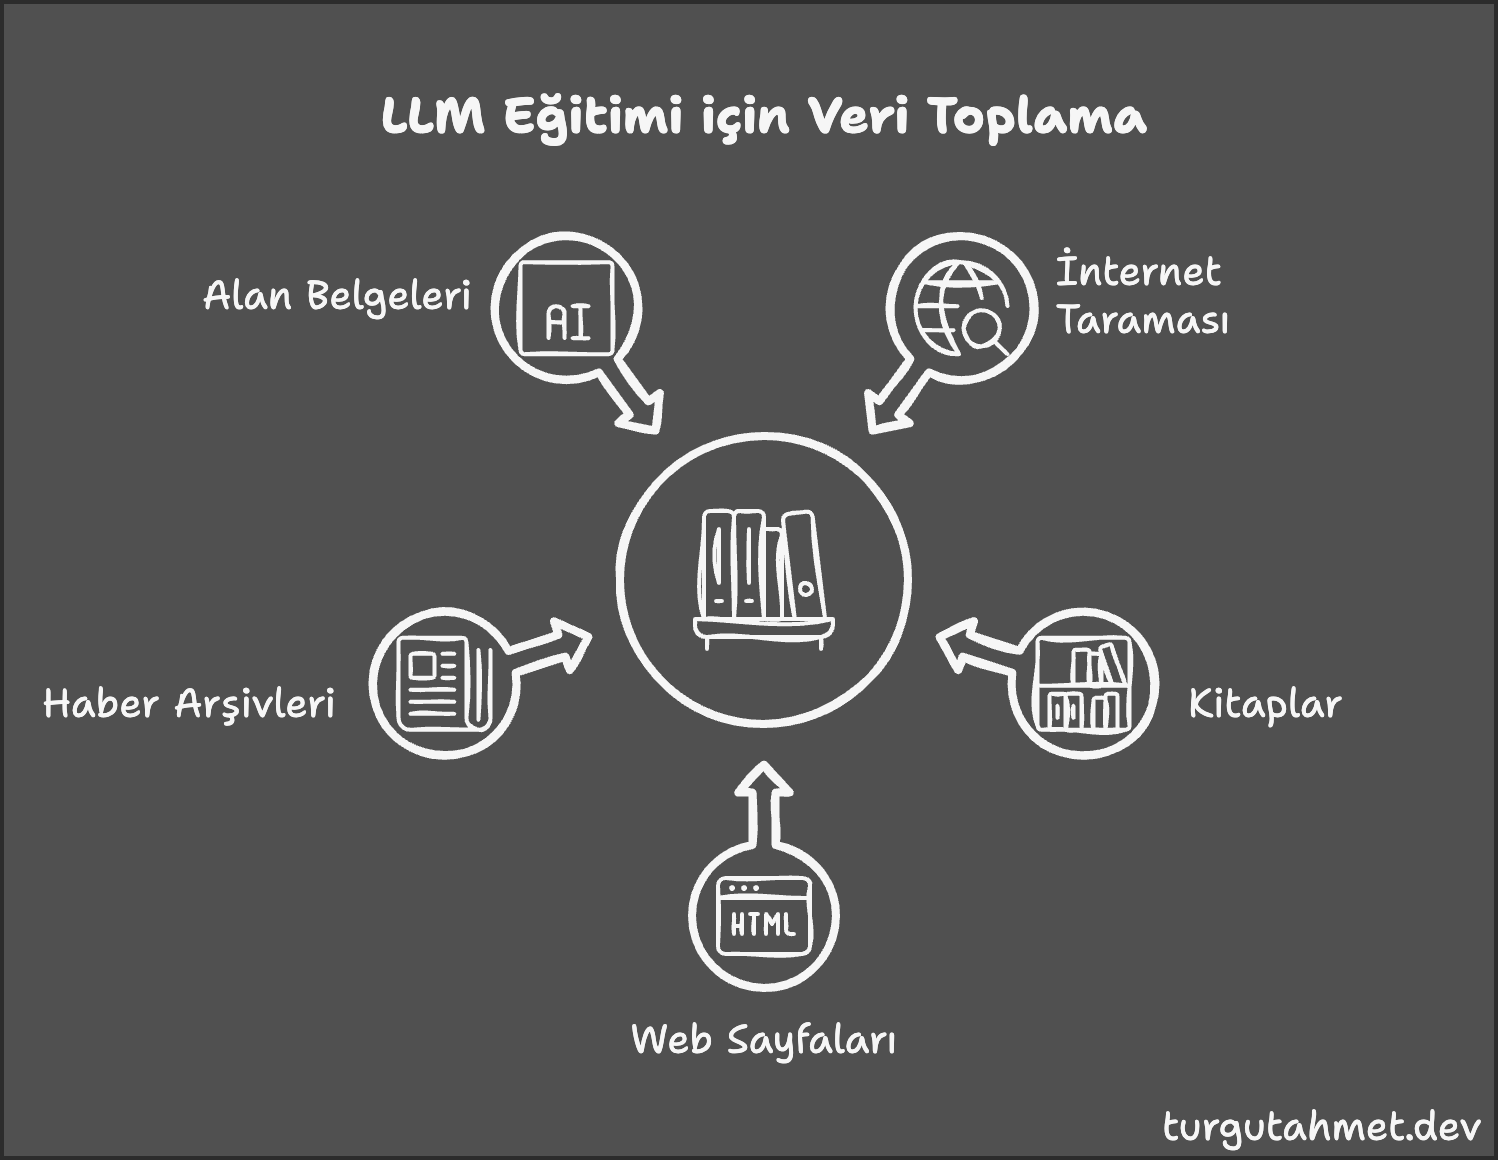
İlk olarak, modelin öğrenebileceği bolca metin toplamak gerekir. İnternetteki devasa kaynaklar (Wikipedia, bloglar, haber siteleri vb.) ve özel alanlara ait belgeler (tıp, hukuk gibi) bu sürecin temelini oluşturur. Ancak toplanan verinin temizlenmesi ve modele uygun hale getirilmesi de en az toplama işlemi kadar önemlidir.
Adımlar:
Ham Veri Toplama:
- Farklı kaynaklardan (Wikipedia, kitaplar, web sayfaları, haber arşivleri) metinler elde edilir.
- Ne kadar çeşitlilik varsa, model o kadar genel dil bilgisi ve bağlam anlayışı edinebilir.
Ön İşleme (Preprocessing):
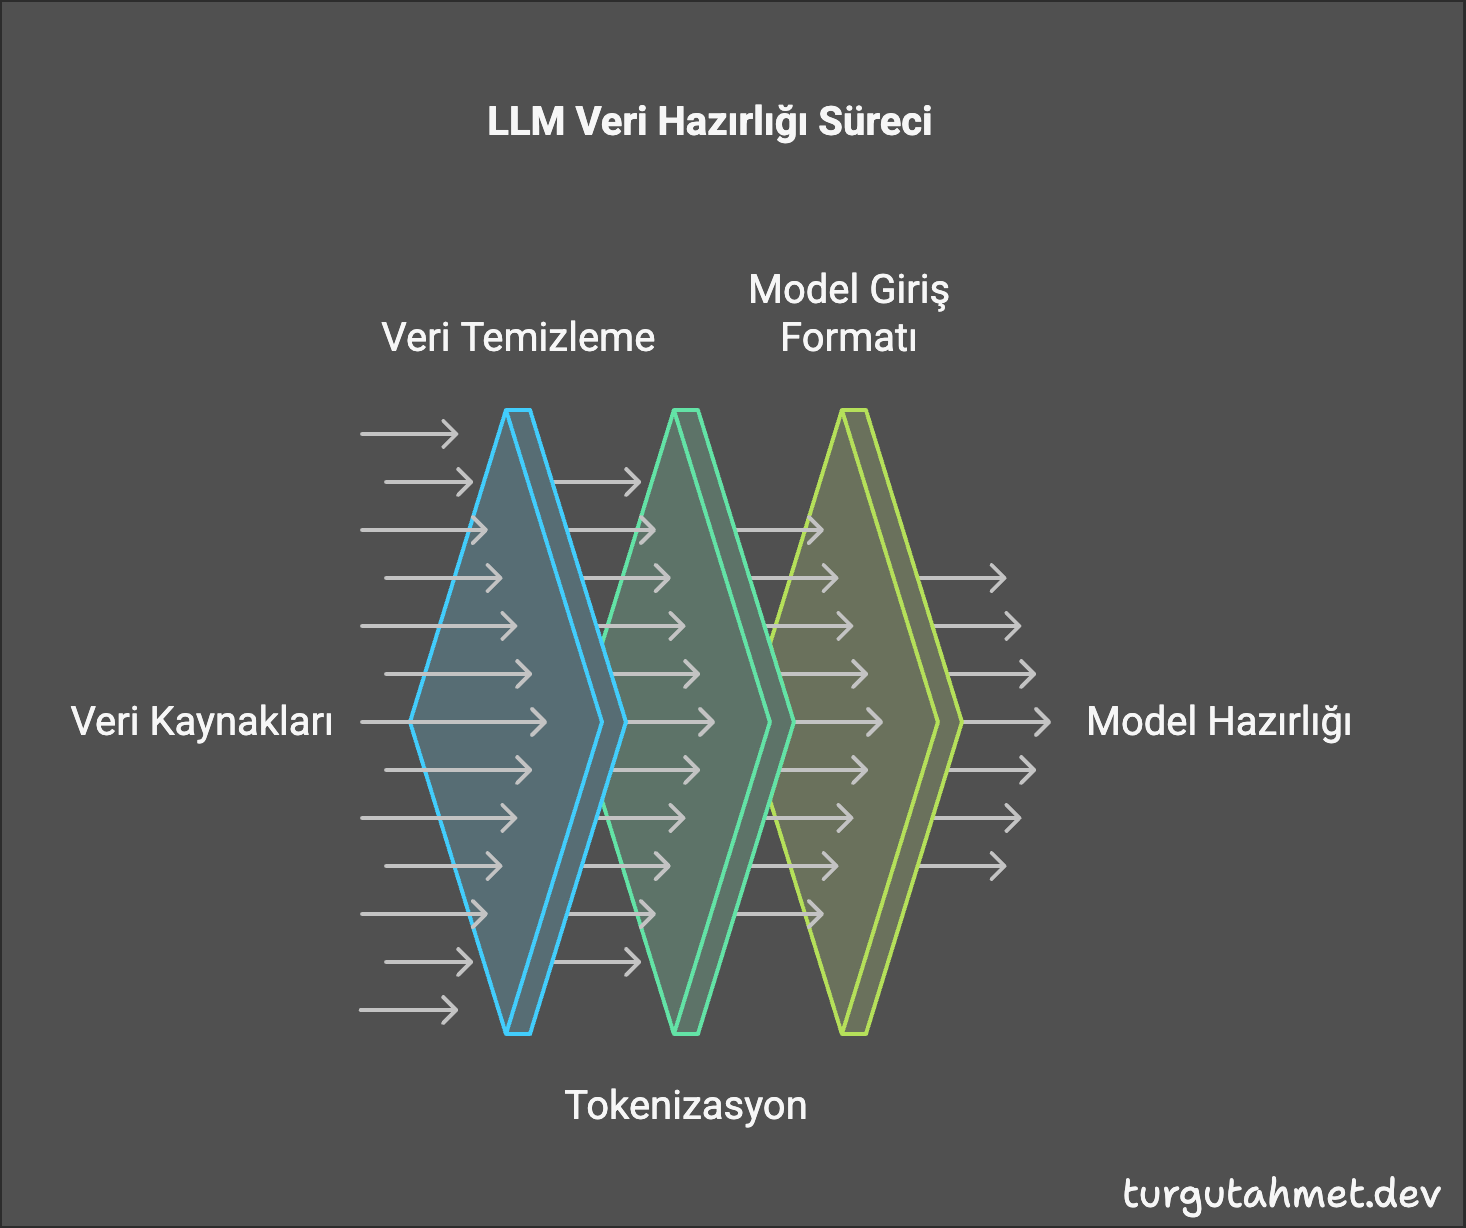
- Metinleri sadeleştirmek için noktalama işaretlerini düzenleme, gereksiz sembolleri silme vb. işlemler yapılır.
- Tokenizasyon adımı ile kelimeleri veya alt parçalara ayırarak (örneğin BPE) modele daha anlaşılır hale getiririz.
- Son olarak veriyi, modelin anlayabileceği formatlara (token ID'leri, attention mask'ları) dönüştürürüz.
1.2.2 Model Mimarisi ve Parametre Ayarları
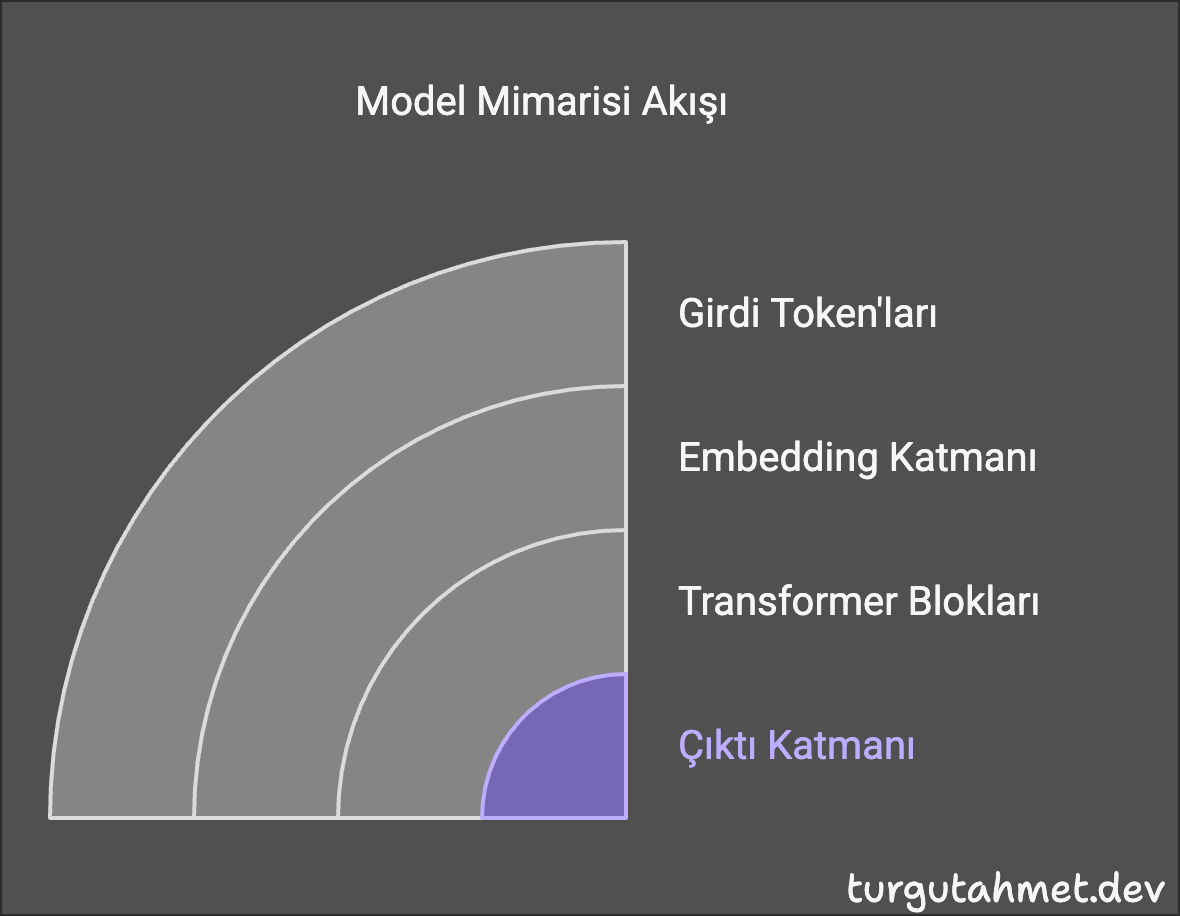
Toplanan ve düzenlenen veriler hazır. Şimdi sıra, Transformer temelli bir yapıyı (Encoder, Decoder veya her ikisi) seçmeye ve hiperparametreleri (öğrenme oranı, batch boyutu gibi) belirlemeye geldi. Bu ayarlar performansı doğrudan etkilediği için oldukça kritik.
Transformer Mimarisi:
- Encoder (BERT tarzı): Metin anlamını kavrama görevlerinde (sınıflandırma, duygu analizi) öne çıkar.
- Decoder (GPT tarzı): Bir metin devamını yazma veya yeni metin oluşturma görevlerinde etkilidir.
- Encoder-Decoder (T5 tarzı): Hem girdiyi anlayabilir hem de çıktı üretebilir. Çeviri ve özetleme gibi çift taraflı işler için idealdir.
Hiperparametreler:
- Öğrenme Oranı (Learning Rate): Modelin ne hızla öğreneceğini ayarlar.
- Batch Boyutu (Batch Size): Her adımda kaç veri örneğini işleyeceğini belirtir.
- Katman Sayısı (Number of Layers): Modelin derinliğini gösterir.
- Başlık Sayısı (Number of Heads): Attention mekanizmasındaki paralel işleyen kanalların sayısı.
- Gizli Katman Boyutu (Hidden Size): Her katmandaki nöron miktarı.
- Dropout Oranı: Overfitting'i azaltmak için katmanlar arasında bağlantıları rastgele kesme oranı.
1.2.3 Eğitim Döngüsü (Training Loop)
Modeli oluşturduk ve veriyi hazırladık. Artık sıra her şeyin birbirine bağlandığı eğitim aşamasında. Model, veri seti üzerinde defalarca dönerek parametrelerini güncelliyor ve en iyi performansa ulaşmaya çalışıyor.
Adımlar:
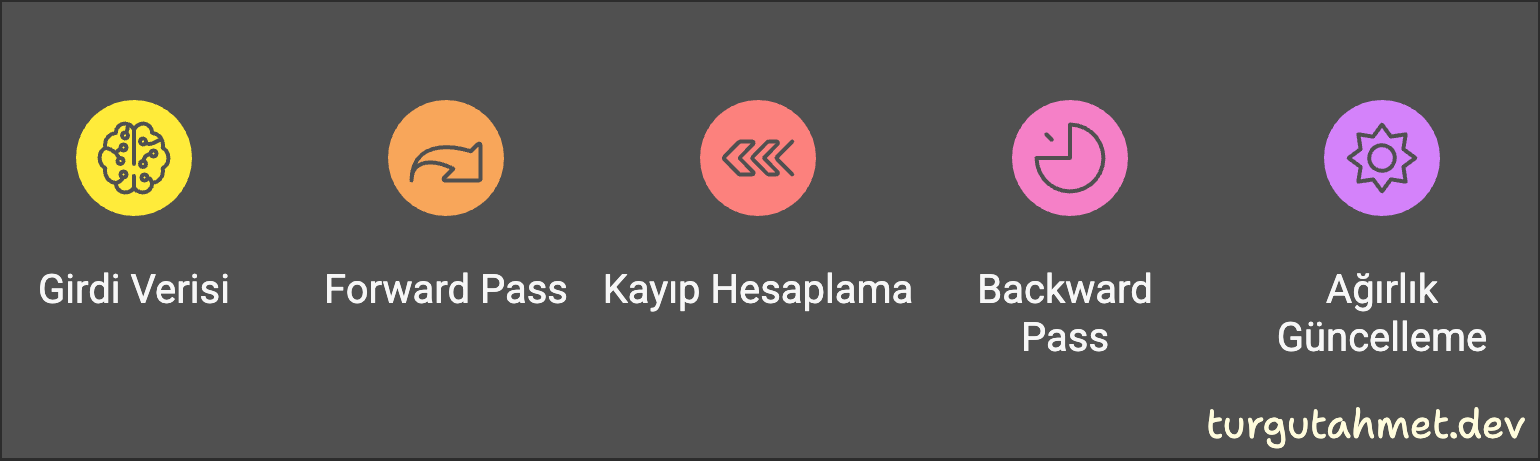
Forward Pass (İleri Yayılım):
- Girdi verisi modele aktarılır ve katmanlar boyunca ilerleyerek tahmini bir çıktı oluşturur.
- Örneğin GPT'de, hangi kelimenin geleceği tahmin edilir.
Loss (Kayıp) Hesaplama:
- Modelin tahmini ile gerçek hedef arasındaki fark ölçülür (örneğin Cross Entropy Loss).
Backward Pass (Geri Yayılım):
- Hesaplanan kaybı (loss) düşürmek için modelin ağırlıkları, gradyan hesaplamalarıyla güncellenir.
Optimizasyon:
- Adam veya AdamW gibi algoritmalar, öğrenme hızını dinamik olarak ayarlayarak eğitim sürecini iyileştirir.
Bu döngü yüzbinlerce, hatta milyonlarca kez tekrar edebilir. Anlayacağınız, LLM eğitimi biraz maraton koşmaya benziyor.
1.2.4 Değerlendirme ve İzleme (Evaluation & Monitoring)
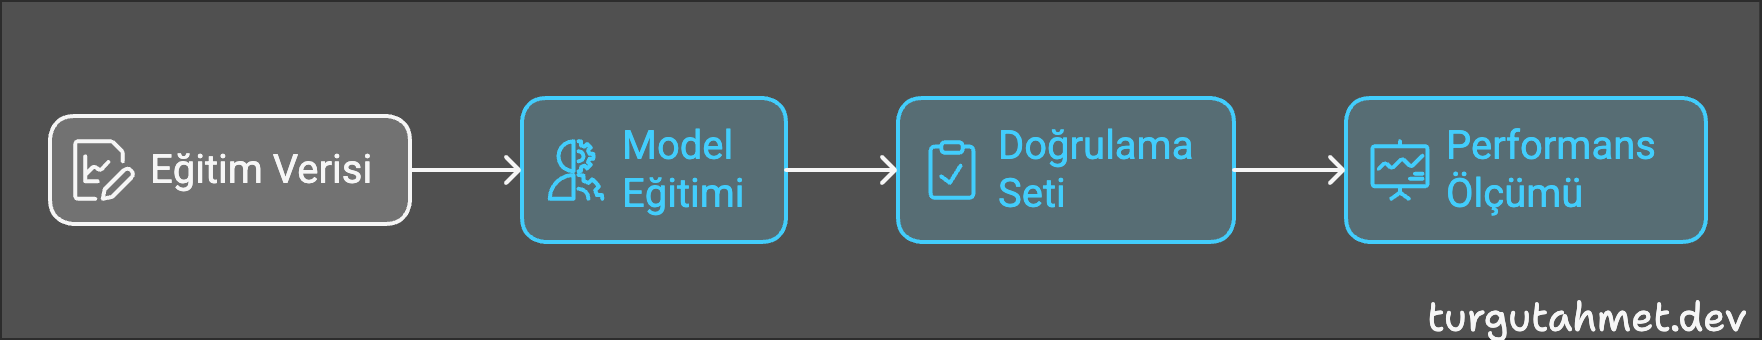
Eğitim devam ederken, modelin gerçekten öğrenip öğrenmediğini görmek için düzenli olarak performans ölçümleri yapılır. Genellikle farklı bir doğrulama seti (validation set) kullanılır ve eğer model bu sette kötüleşmeye başlarsa eğitimi durdurmak (early stopping) gibi yöntemlere başvurulur.
Adımlar:
Validation Set (Doğrulama Seti):
- Modelin hiç görmediği verilerle periyodik olarak testler yapılır.
- Hedef, aşırı uyum (overfitting) sorunu yaşamadan genel olarak iyi bir performans elde etmektir.
Early Stopping:
- Modelin eğitimini, doğrulama hatası artmaya başladığında sonlandırarak gereksiz yere zaman ve kaynak harcanmasının önüne geçilir.
1.2.5 Eğitim Sonrası Süreç (Post-Training)
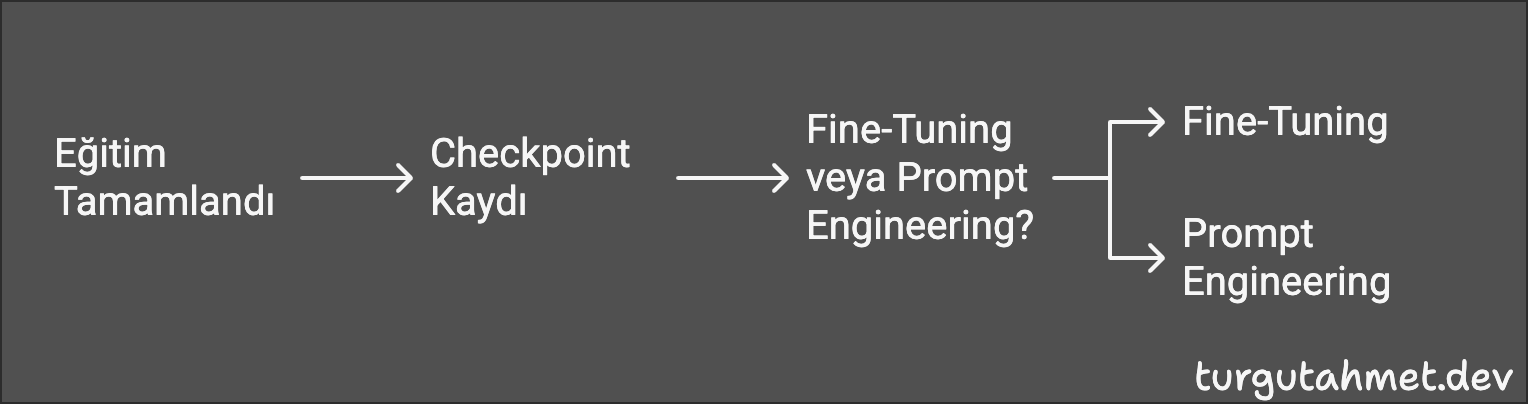
Eğitimi başarıyla tamamladık diyelim. Sırada modelin farklı görevlere uyarlanması ya da doğrudan kullanıma alınması var. Bu noktada checkpoint kaydetme ve fine-tuning gibi aşamalara geçiliyor.
Adımlar:
Checkpoint Kaydı:
- Eğitim sırasında farklı zamanlarda modelin ağırlıklarını kaydetmek, istediğimiz versiyona dönmeyi kolaylaştırır.
Modelin Uyarlanması (Adaptation):
- Örneğin, çok genel bir dil modeli spesifik tıbbi metinler üzerinde tekrar eğitilebilir (fine-tuning) ya da prompt engineering ile hızlıca uyarlanabilir.
1.3 LLM Eğitiminin Avantajları ve Dezavantajları
Avantajları:
- Geniş Uyarlanabilirlik: Birçok NLP görevine kolayca uyum sağlayabilirler.
- Yüksek Başarı Oranı: İnsan benzeri metin üretimi ve derin bağlam analizi.
- Çok Yönlülük: Chatbot, özetleme, tercüme gibi birçok farklı görevde kullanılabilir.
Dezavantajları:
- Kaynak Yoğunluğu: Eğitim süreci yüksek GPU/TPU maliyeti ve çok miktarda zaman ister.
- Büyük Veri Gereksinimi: Kaliteli ve temiz veri toplamak başlı başına bir iştir.
- Çıktı Denetimi: Büyük modellerin hata yapma veya gerçek olmayan bilgi üretme riski mevcuttur.
1.4 Fine-Tuning Nedir?
Her ne kadar LLM'ler devasa veri setleri üzerinde genel dil bilgisini çok iyi öğrenseler de, örneğin tıbbi terimleri veya hukuki kavramları derinlemesine anlamaları için ekstra eğitime ihtiyaç duyabilirler. Bu özel eğitim sürecine "fine-tuning" diyoruz.
Fine-tuning yaparken, modelin temel becerileri (dil bilgisi, genel dünya bilgisi gibi) korunurken, hedeflediğimiz alan veya göreve ilişkin detayları modelin öğrenmesini sağlarız. Hem veri ihtiyacı hem de maliyet, sıfırdan eğitime göre çok daha düşüktür.
Günümüzde LoRA (Low-Rank Adaptation) ve PEFT (Parameter-Efficient Fine-Tuning) gibi yöntemler yaygınlaştı. Böylece modelin tüm parametrelerini eğitmek yerine eklenen birkaç katmanı eğiterek, hem kaynak kullanımını azaltabiliyor hem de eğitimi hızlandırıyoruz.
Bu noktada Hugging Face gibi platformlar, önceden eğitilmiş modellere hızlıca ulaşmayı sağlarken, Unsloth gibi projeler özellikle büyük modellerin (LLaMA, Mistral vb.) fine-tuning sürecini optimize ediyor. İlerleyen kısımlarda bu araçların nasıl kullanıldığını da örneklerle göreceğiz.
1.5 Hugging Face ve Unsloth'un Rolü
Hugging Face, NLP dünyasında adını sıkça duyduğumuz, kullanıcılarına binlerce model ve veri seti sunan bir ekosistemdir. Transformers kütüphanesi sayesinde GPT, BERT, T5 gibi popüler modelleri kullanmak son derece kolaydır. Ayrıca Hugging Face Hub, topluluk odaklı yaklaşımıyla herkesin kendi model ve veri setini paylaşabileceği bir platform sunar.


Hugging Face'in Fine-Tuning Sürecindeki Rolü:
- Hazır Modellere Erişim: Saniyeler içinde dilediğiniz önceden eğitilmiş modeli indirebilirsiniz.
- Veri Seti Seçenekleri: Hugging Face Hub, birçok farklı veri setine de ev sahipliği yapar.
- Eğitim ve Değerlendirme Araçları: Modeli eğitme ve performansını ölçme aşamalarında kullanabileceğiniz hazır fonksiyonlar sunar.
Unsloth'un Fine-Tuning Sürecindeki Rolü:
Unsloth, özellikle büyük dil modellerinin eğitim sürecini daha verimli kılmak için geliştirilmiş bir araçtır. LoRA ve PEFT gibi yöntemleri destekleyerek, modelin tamamını eğitmek yerine ek parametreler üzerinden yenilikler yapmaya olanak tanır.
Unsloth'un Avantajları:
- Bellek Tasarrufu: LoRA ve PEFT yöntemleri sayesinde devasa model boyutlarında bile bellek kullanımını düşürebilir.
- Daha Hızlı Eğitim: Daha az parametre güncellendiğinden, eğitim süreci de hızlanır.
- Hugging Face Entegrasyonu: Mevcut Hugging Face iş akışınıza kolayca eklenebilir.
Örnek Kullanım Senaryosu:
- Hugging Face Hub'dan istediğiniz LLM'i ve veri setini indirirsiniz.
- Unsloth kullanarak LoRA veya PEFT yöntemleriyle fine-tuning başlatırsınız.
- Hugging Face'in Trainer API'si veya benzeri araçlarla eğitimi ve değerlendirmeyi gerçekleştirirsiniz.
- İşlem bitince modelinizi tekrar Hugging Face Hub'a yükleyerek yayınlayabilirsiniz.
Sonuç:
Hugging Face ve Unsloth, büyük dil modellerinin ince ayar (fine-tuning) sürecini baştan sona kolaylaştıran ve optimize eden iki önemli bileşendir. Hugging Face, model ve veri seti seçiminizi çocuk oyuncağına çevirirken, Unsloth da bellek ve hız konusunda size büyük avantajlar sunar. İkisini bir arada kullanarak oldukça başarılı, özelleştirilmiş NLP çözümleri geliştirmek mümkün.
2. Fine-Tuning'in Temelleri
2.1 Fine-Tuning Nasıl Çalışır?
Fine-tuning, önceden eğitilmiş bir modelin becerilerini yeni bir göreve uyarlama prensibine dayanır. Böylece modelin zaten kazanmış olduğu dil bilgisi ve kalıp anlayışı, küçük bir dokunuşla başka bir alanda tekrar işe koşulur. "Transfer öğrenme" olarak bilinen bu yaklaşım, zaman ve kaynak açısından ciddi tasarruf sağlar.
Mesela, BERT'i düşünün. BERT devasa metinlerde eğitildiğinden dilin gramer kurallarını, sözcük dağarcığını ve metin içi ilişkileri çok iyi kavramıştır. Bu altyapı üzerine, örneğin duygusal analiz yapmak istiyorsanız, son katmanlarını veya belirli parametrelerini "ince ayar" (fine-tuning) işlemiyle yeniden eğitebilirsiniz. Böylece model, kısa sürede yeni görevinize adapte olur.
2.2 Fine-Tuning Türleri
- Tam Fine-Tuning (Full Fine-Tuning): Modelin bütün parametrelerini yeniden eğitir. Eğer elinizde bolca veri varsa ve çok spesifik bir proje için çalışıyorsanız iyi bir seçenektir; ancak GPU belleği ve işlem gücü ihtiyaçları daha yüksektir.
- Kısmi Fine-Tuning (Partial Fine-Tuning): Genellikle son katmanlar veya belirli bölümler yeniden eğitilir. Daha hızlıdır ve daha az kaynağa ihtiyaç duyar.
- LoRA (Low-Rank Adaptation) ve PEFT (Parameter-Efficient Fine-Tuning): Bu yöntemlerde modelin ana gövdesi çoğunlukla sabit kalır. Eklenen düşük boyutlu parametrelerle veya ek katmanlarla ince ayar yapılır. Böylece bellek tasarrufu ve hız avantajı elde edilir.
2.3 Fine-Tuning için Gerekenler
Donanım Gereksinimleri:
- En az bir GPU veya TPU (büyük modeller için birden fazla GPU gerekebilir)
- Model boyutu arttıkça GPU belleği ihtiyacı da artar
Yazılım Gereksinimleri:
- Python
- PyTorch veya TensorFlow (biri yeterli)
- Hugging Face Transformers kütüphanesi
- Veri yönetimi için datasets kütüphanesi
- Gerekirse Unsloth veya benzeri araçlar
3. Dataset Oluşturma ve Formatları
3.1 Dataset Oluşturma Süreci
"Kaliteli veri = başarılı model" demek biraz klişe gibi görünse de, çoğu zaman doğru bir ifadedir. Fine-tuning yaparken kullanacağınız veri seti, modelin uzmanlaşacağı konuyu belirler. Bu nedenle veri toplama, temizleme ve ön işleme adımları çok önemlidir.
- Veri Toplama: İhtiyaç duyulan alana uygun veri kaynakları seçilir (Wikipedia, özel kurumsal veriler vb.).
- Veri Temizleme: Yinelenen satırları, hatalı etiketleri, gereksiz sembolleri ayıklamak gerekir.
- Ön İşleme: Tokenizasyon, büyük/küçük harf düzenlemesi veya gerekiyorsa durak kelimeleri filtreleme.
3.2 Dataset Formatları
Özellikle talimat (instruction) tabanlı öğretim için "Alpaca Formatı" kullanıldığında, veri yapısı hem girdi hem de çıktıyı barındıracak şekilde düzenlenir.
{
  "instruction": "Write a short poem about the night sky.",
  "input": "",
  "output": "Twinkling lights adorn the velvet night..."
}
Bu şablonda, instruction alanı modelden ne yapmasını istediğinizi, input varsa ek bilgiyi, output ise hedef yanıtı tutar.
- JSON / CSV / TXT: Geleneksel formatlar hâlâ çok yaygın.
- Hugging Face Dataset Formatı:
datasetskütüphanesiyle verileri okurken kullanılan optimize edilmiş Arrow formatı.
4. Hugging Face ile Dataset Yükleme ve Paylaşma
4.1 Dataset Yükleme ve İşleme
Hugging Face'in datasets kütüphanesiyle çalışmak gerçekten pratik. CSV veya JSON dosyalarınızı tek satırda yükleyebilir veya Hub'da paylaşılan bir veri setini doğrudan kullanabilirsiniz:
from datasets import load_dataset
dataset = load_dataset("ahmetturgut/testBio")
# Kendi veri setinizin ismini yazabilirsiniz.
4.2 Örnek Proje: Alpaca Formatında Dataset Oluşturma
Diyelim ki bir CSV dosyanız var ve bunu Hugging Face Hub'a yükleyerek Alpaca formatına dönüştürmek istiyorsunuz. Aşağıdaki kod parçacığı, Colab üzerinde bu adımları nasıl gerçekleştirebileceğinizi gösteriyor:
# Gerekli kütüphanelerin yüklenmesi
! pip install datasets
! pip install huggingface_hub

from huggingface_hub import login
from datasets import Dataset
import pandas as pd

# Hugging Face token girişi
login()

# CSV dosyasından veri okunması
input_df = pd.read_csv("dataset.csv")

# DataFrame'i Dataset objesine dönüştürüp train-test olarak ayırma
dataset = Dataset.from_pandas(input_df)
dataset = dataset.train_test_split(test_size=0.1)

# Veri setini Hugging Face Hub'a yükleme
dataset.push_to_hub("ahmetturgut/testBio")
Gördüğünüz gibi, birkaç satır kodla veri setinizi kolayca Hub'a yükleyip paylaşabilirsiniz. Sonraki aşamada ise bu veriyi indirip fine-tuning sürecinize dahil edebilir veya model geliştirme çalışmalarınızda hemen kullanabilirsiniz.
| Instruction | Input | Response |
|---|---|---|
| Explain the cleaning and disinfection procedure for BiO2Flow | How are cleaning and disinfection procedures performed? | Cleaning procedure: 1. Turn off device and disconnect power 2. Wear protective equipment 3. Remove detachable parts 4. Clean with appropriate disinfectant 5. Allow to dry Note: Flammable cleaning agents must not be used |
| Explain the humidifier chamber setup steps for BiO2Flow | How is the humidifier chamber prepared and installed? | Humidifier chamber setup steps: 1. Connect chamber with connection apparatus 2. Make sterile water connection 3. Press the locking mechanism 4. Attach chamber to device in correct orientation 5. Verify connection security |
| List the safety warnings for BiO2Flow device | What are the safety precautions for device use? | Important safety warnings: 1. Must only be operated by authorized medical personnel 2. Alternative respiratory source must be available 3. Must not be used in environments with flammable gases 4. Device must not be used during radiotherapy 5. Must only be plugged into grounded outlets 6. Only Biosys-approved accessories must be used |
| Explain the main features of the BiO2Flow high-flow oxygen therapy device | General information about BiO2Flow device is requested | BiO2Flow is a device used for treating spontaneously breathing patients who would benefit from high-flow, heated and humidified respiratory gases. Main features: - Flow rate up to 110 lpm - Precise FiO2 adjustment (21-100%) - Integrated humidifier and nebulizer - Integrated battery - One-touch operation |
| List the technical specifications of BiO2Flow | What are the device's technical specifications? | Technical Specifications: - Flow: 5-110 L/min (5 lpm resolution) - FiO2: 21-100% (1% resolution) - Temperature: 31-37°C - Pressure Sources: Air (Internal Blower), Oxygen (2.5-7 Bar) - Safety Class: Class II, Type BF - IP Protection: IP21 |
Bu örnek veri seti, BiO2Flow cihazının kullanım talimatlarını ve teknik özelliklerini içeren instruction-tuning formatında hazırlanmış bir datasettir. Hugging Face Hub'da ahmetturgut/testBio repository'sinde paylaşılmıştır.
5. Unsloth ile Fine-Tuning Süreci
Bu bölümde Unsloth'u kullanarak büyük dil modellerini (LLM) nasıl ince ayar (fine-tune) edebileceğinizi adım adım ve "insan gözüyle anlaşılır" bir şekilde anlatmaya çalışacağız. Yapacağımız her kod hücresinin ve her konfigürasyon ayarının ne işe yaradığını net bir dille açıklayacağız. Ayrıca, LoRA (Low-Rank Adaptation) ve PEFT (Parameter-Efficient Fine-Tuning) gibi güncel tekniklerle hem bellek kullanımını nasıl azaltabileceğinizi hem de eğitimi nasıl hızlandırabileceğinizi öğreneceksiniz.
Özetle Unsloth, LLM'leri ince ayar yapmayı kolaylaştıran bir kütüphane. Klasik yöntemlerle devasa boyutlardaki parametrelerin tamamını yeniden eğitmek yerine, LoRA ve PEFT gibi ek yöntemlerle modelin yalnızca birkaç yeni katmanını veya belirli parametrelerini eğitebiliyorsunuz. Bu sayede çok büyük hafızalara (RAM/GPU) ihtiyaç duymadan ya da upuzun eğitim süreleri beklemeden istediğiniz sonuca ulaşmak mümkün hâle geliyor.
Aşağıdaki alt başlıklarda, Google Colab üzerinde Unsloth kurulumu, eğitilmiş bir modeli nasıl kullanacağınız, LoRA adaptörlerini projenize nasıl entegre edeceğiniz ve modeli nasıl kaydedip yeniden yükleyebileceğinize dair pratik örnekler bulacaksınız. İstediğiniz yerden başlayabilir, ihtiyaç duyduğunuzda geri dönüp bakabilirsiniz.
5.1 Unsloth Kurulumu
Başlangıç adımlarımız oldukça basit. Google Colab gibi bir ortamda tek bir pip komutuyla Unsloth'u kurabiliriz. Sadece birkaç dakika içinde büyük dil modellerini ince ayar (fine-tune) etmeye hazır hâle geleceksiniz.
5.2 LoRA Adaptörlerini Ekleyerek Fine-Tuning
LoRA (Low-Rank Adaptation), büyük modellerin tüm katmanlarını baştan sonra eğitmek yerine, yalnızca belirli parametrelerini güncellememizi sağlayan bir teknik. Özellikle modelin q_proj, k_proj gibi projeksiyon katmanlarını hedef alarak hafızadan ve zamandan ciddi tasarruf edebiliyoruz. Dolayısıyla "benim GPU belleğim çok kısıtlı" veya "daha hızlı bitmesini istiyorum" diyenler için LoRA baş tacı.
5.3 Veri Hazırlama
Unsloth veya diğer fine-tuning süreçlerinde kaliteli veri seti neredeyse her şey demek. Burada Alpaca gibi talimat tabanlı (instruction-based) veri setlerini nasıl düzenleyebileceğinizi gösteriyoruz. Örneğin, "Instruction", "Input" ve "Response" alanlarını bir araya getirirken sonuna mutlaka EOS_TOKEN (End of Sequence) eklediğinizden emin olun. Aksi takdirde model sonsuza kadar kendi kendine konuşabilir!
5.4 Modeli Eğitme
Eğitim kısmında Hugging Face ekosisteminden SFTTrainer (Supervised Fine-Tuning Trainer) sınıfını kullanacağız. Burada öğrenme oranı, batch boyutu, kaç adım eğiteceğimiz gibi temel parametreleri belirliyoruz. Kod bloğundan korkmayın, her satırı tek tek yorumlayacağız. Eğer GPU belleğiniz kritik seviyede dolarsa, gradient_accumulation_steps veya batch_size gibi ayarları gözden geçirerek sisteminizi rahatlatabilirsiniz.
5.5 Modeli Kaydetme ve Kullanma
Eğitiminiz tamamlandıktan sonra modelinizin son hâlini korumak isteyeceksiniz. Unsloth, yerel olarak kaydetmenize veya direkt Hugging Face Hub'a yüklemenize imkân veriyor. Böylece projenizi dilediğiniz zaman kaldığı yerden devam ettirebilir, ekibinizle paylaşabilir veya farklı bir makinede çalışmaya devam edebilirsiniz.
Şimdi tüm bu adımlara ait kod parçalarını biraz daha yakından inceleyelim. Kod örneklerini çalıştırırken karşılaşabileceğiniz yaygın hatalara ve dikkat etmeniz gereken püf noktalara da yer vereceğiz.
5.6 Adım Adım Kod Açıklaması
Colab üzerinden Unsloth ile fine-tuning sürecini görmek için aşağıdaki linki kullanabilirsiniz.
Google Colab Notebook
5.6.1 Giriş ve Kurulum
Bu ilk kod hücresinde çalışma ortamımızı kuruyor ve Unsloth'a hızlı bir başlangıç yapıyoruz. Eğer Google Colab kullanıyorsanız "Runtime > Run all" menüsünden tüm hücreleri bir kerede çalıştırabilirsiniz. Sık sık sorulan "Nerede docs?" veya "Nasıl iletişim kurarım?" sorularının cevabı da hücre içerisindeki linklerde mevcut.
# To run this, press "Runtime" and press "Run all" on a free Tesla T4 Google Colab instance!
# Basic instructions to get started with Unsloth.
# Also includes a link to Discord, documentation, and so on.
5.6.2. Unsloth'un Yüklenmesi
Burada pip install unsloth komutuyla kütüphaneyi indiriyoruz. Ardından, en güncel sürümlere ulaşmak için --force-reinstall ve --no-cache-dir gibi parametreleri kullanıyoruz. Bu sayede "Neden eski sürüm kuruldu?" veya "Benim sürümüm neden çalışmıyor?" tarzı hatalarla karşılaşma ihtimalimiz azalıyor.
%%capture
!pip install unsloth
# Also get the latest nightly Unsloth!
!pip install --force-reinstall --no-cache-dir --no-deps git+https://github.com/unslothai/unsloth.git
5.6.3. Model ve Tokenizer Yükleme
Hugging Face üzerinden Meta-Llama-3.1-8B modelini indirip FastLanguageModel.from_pretrained metodu ile yüklüyoruz. load_in_4bit seçeneğini kullanarak 4bit quantization etkinleştirdiğimizde, RAM ve GPU belleği kullanımını büyük ölçüde hafifletmiş oluyoruz. Bu da eğitimin daha düşük donanımlarda bile yapılabilmesini sağlıyor.
from unsloth import FastLanguageModel
import torch
max_seq_length = 2048 # Feel free to pick a sequence length
dtype = None # Let Unsloth choose the best dtype automatically
load_in_4bit = True # 4bit quantization for memory efficiency

fourbit_models = [
    "unsloth/Meta-Llama-3.1-8B-bnb-4bit",
    "unsloth/Meta-Llama-3.1-70B-bnb-4bit",
    "unsloth/Mistral-Nemo-Base-2407-bnb-4bit",
    # ... see https://huggingface.co/unsloth for all available
]

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Meta-Llama-3.1-8B",
    max_seq_length = max_seq_length,
    dtype = dtype,
    load_in_4bit = load_in_4bit,
    # token = "hf_..." # required for gated models
)
5.6.4. LoRA Adaptörlerini Eklemek
LoRA adaptörlerini eklemek için FastLanguageModel.get_peft_model fonksiyonunu çağırıyoruz. Burada r=16, lora_alpha=16 gibi parametreler LoRA'nın kapasitesini belirliyor. Hangi katmanların eğitileceğini target_modules listesiyle seçebiliyorsunuz. Böylece modelin ihtiyaç duymadığı katmanlara dokunmamış oluyorsunuz.
model = FastLanguageModel.get_peft_model(
    model,
    r = 16,
    target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                      "gate_proj", "up_proj", "down_proj"],
    lora_alpha = 16,
    lora_dropout = 0,
    bias = "none",
    use_gradient_checkpointing = "unsloth",
    random_state = 3407,
    use_rslora = False,
    loftq_config = None,
)
5.6.5. Veri Hazırlığı (Data Prep)
Burada Alpaca veri seti üzerinden bir örnek veriyoruz. Ama tabii ki kullanacağınız talimat (instruction) formatını istediğiniz gibi kişiselleştirebilirsiniz. Önemli nokta, modelin soruyu ve cevabı net biçimde ayırabilmesi. Ayrıca EOS_TOKEN kullanarak, modelin metni nerede bitirmesi gerektiğini düzgün şekilde işaretlemek de kritik.
alpaca_prompt = """Below is an instruction...
### Instruction:
{}

### Input:
{}

### Response:
{}"""

EOS_TOKEN = tokenizer.eos_token

def formatting_prompts_func(examples):
    instructions = examples["instruction"]
    inputs       = examples["input"]
    outputs      = examples["output"]
    ...
    # Return dictionary with "text" key so SFTTrainer can read
    return { "text" : texts }
5.6.6. Eğitim (Train) Aşaması
Eğitime geçtiğimizde train_dataset, per_device_train_batch_size, gradient_accumulation_steps gibi argümanları dikkatlice seçmemiz gerekiyor. Çünkü bunlar eğitim performansını ve hızını doğrudan etkiler. Eğer "out of memory" hatası alıyorsanız, batch_size veya max_steps gibi parametreleri azaltmayı deneyebilirsiniz.
from trl import SFTTrainer
from transformers import TrainingArguments
from unsloth import is_bfloat16_supported

trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    dataset_text_field = "text",
    args = TrainingArguments(
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4,
        max_steps = 60,
        learning_rate = 2e-4,
        output_dir = "outputs",
        report_to = "none",  # set "wandb" if you want to track metrics with Weights & Biases
    ),
)

trainer_stats = trainer.train()
5.6.7. İnferens (Inference) Aşaması
Eğitim bittikten sonra modeli test etmek için FastLanguageModel.for_inference(model) diyerek "inference moduna" geçiriyoruz. Ardından model.generate() ile istediğimiz soruları veya girdileri vererek yanıt üretebiliyoruz. Eğer cevabı satır satır görmek isterseniz TextStreamer kullanabilirsiniz; böylece jenerasyon anbean ekranda belirir.
FastLanguageModel.for_inference(model)
inputs = tokenizer(["Explain quantum physics like I'm 5"], return_tensors = "pt").to("cuda")
outputs = model.generate(**inputs, max_new_tokens = 64, use_cache = True)
tokenizer.batch_decode(outputs)
5.6.8. Modeli Kaydetme ve Yükleme
Eğitim tamamlandığında, LoRA adaptörlerinin son hâlini model.save_pretrained("lora_model") komutuyla kaydedebilirsiniz. Böylece aynı konfigürasyon ve katmanlarla eğitilmiş modelinizi farklı bir sunucuda veya aynı Colab oturumunda tekrar kullanabilirsiniz. Kaydettiğiniz klasörü FastLanguageModel.from_pretrained ile kolayca geri yükleyebilirsiniz.
model.save_pretrained("lora_model")
tokenizer.save_pretrained("lora_model")

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "lora_model",
    ...
)
5.6.9. Farklı Formatlarda Kaydetme (4bit, float16, GGUF)
Unsloth ayrıca finetune ettiğiniz modeli farklı formatlarda saklamanıza da olanak tanır. Örneğin "16bit"le birleştirebilir, "4bit" formatında minimal boyutlu bir versiyon oluşturabilir ya da GGUF gibi kitaplıklarla uyumlu hâle getirebilirsiniz. İhtiyacınız olan kullanım senaryosuna göre bu seçeneklerden birini tercih etmeniz yeterli. save_pretrained_gguf fonksiyonu ile modelinizin GGUF formatını local olarak saklanmasını sağlayabilirsiniz. push_to_hub_gguf fonksiyonu ile modelinizi Hugging Face üzerinden paylaşabilirsiniz.
# Save to 8bit Q8_0
if False: model.save_pretrained_gguf("model", tokenizer,)
# change ahmetturgut to your username!
if False: model.push_to_hub_gguf("ahmetturgut/testBio", tokenizer, token = "")

# Save to 16bit GGUF
if False: model.save_pretrained_gguf("model", tokenizer, quantization_method = "f16")
if False: model.push_to_hub_gguf("ahmetturgut/testBio", tokenizer, quantization_method = "f16", token = "")

# Save to q4_k_m GGUF
if False: model.save_pretrained_gguf("model", tokenizer, quantization_method = "q4_k_m")
if False: model.push_to_hub_gguf("ahmetturgut/testBio", tokenizer, quantization_method = "q4_k_m", token = "")
Public olarak paylaşılan modelimi görmek için aşağıdaki linki kullanabilirsiniz.
ahmetturgut/testBio
6. Son Söz ve Ek Bağlantılar
Bu yazıda LLM'lerin ne olduğunu, nasıl eğitildiğini, fine-tuning süreçlerini ve Hugging Face ile Unsloth gibi araçların bu süreçlerdeki rolünü ele aldık. Büyük dil modellerinin etkileyici gücüne rağmen, verimli kullanım için dikkat edilmesi gereken detaylara değinmek önemlidir. Umarım bu rehber, kendi projelerinizi hayata geçirirken size yol gösterir.
Ek Kaynaklar:
- Hugging Face Resmi Sitesi
- Unsloth Github Repository
- Transformer: Attention is All You Need
- PyTorch Resmi Sitesi
- Napkin AI (Yazıda kullanılan Şemaları oluşturmak için)
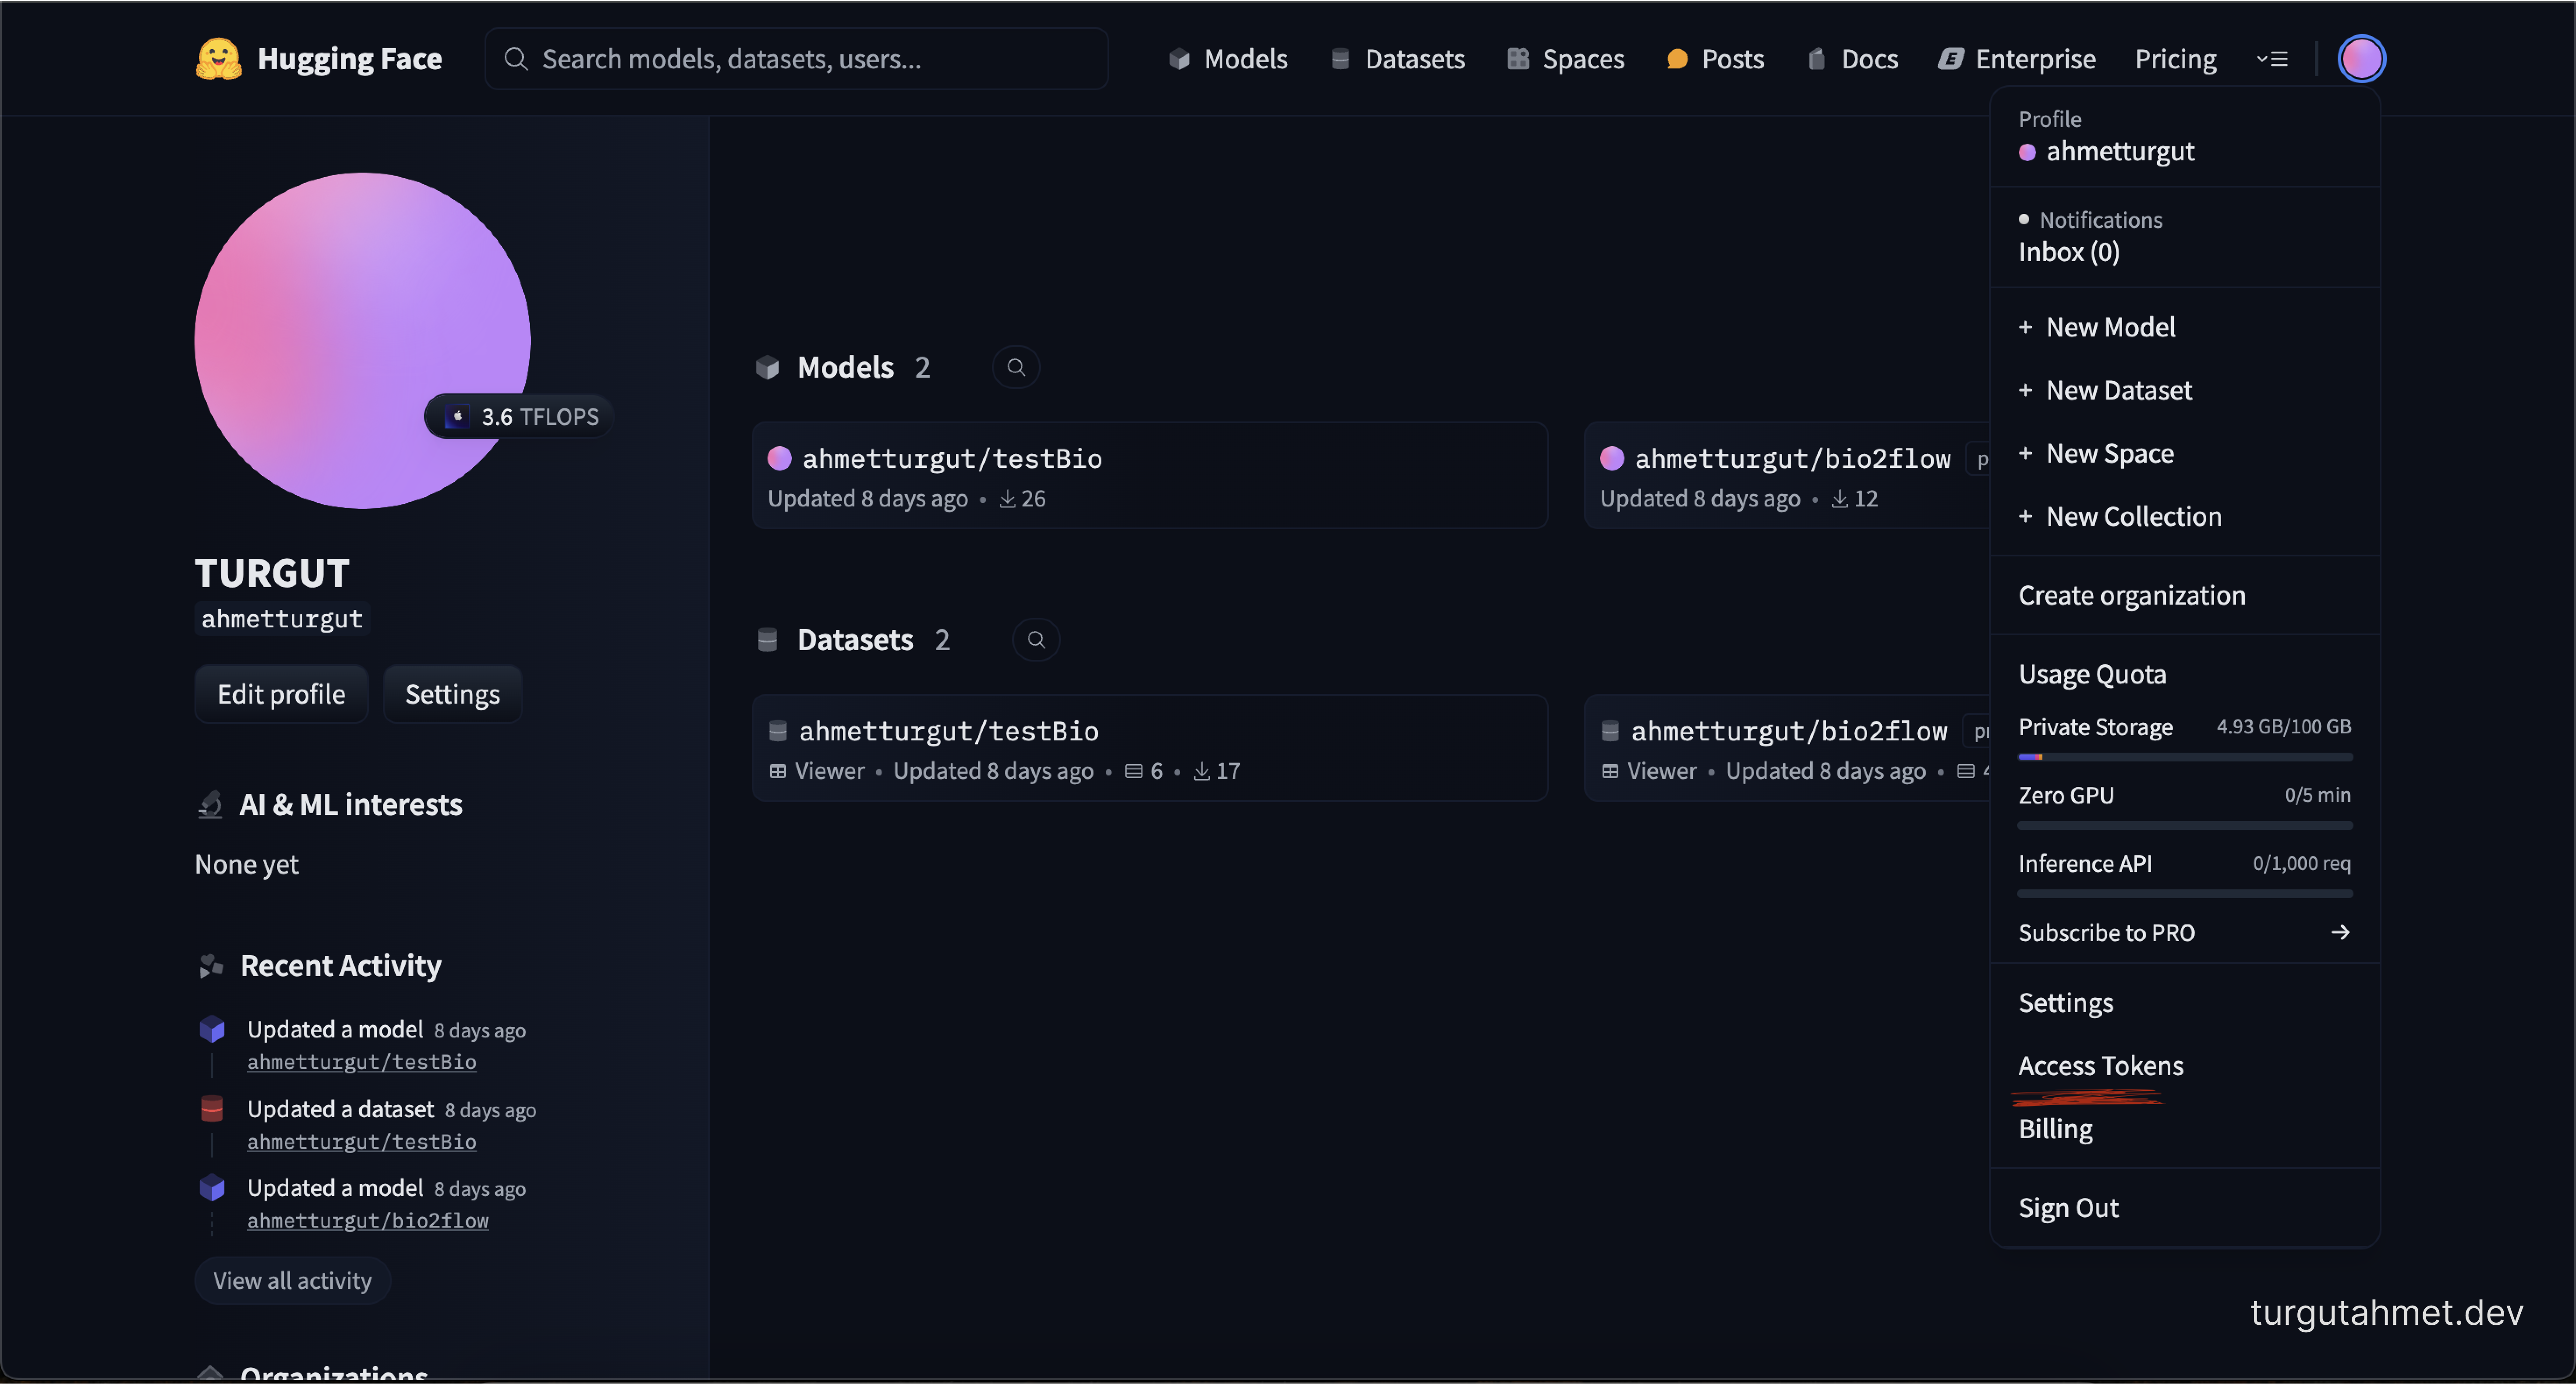
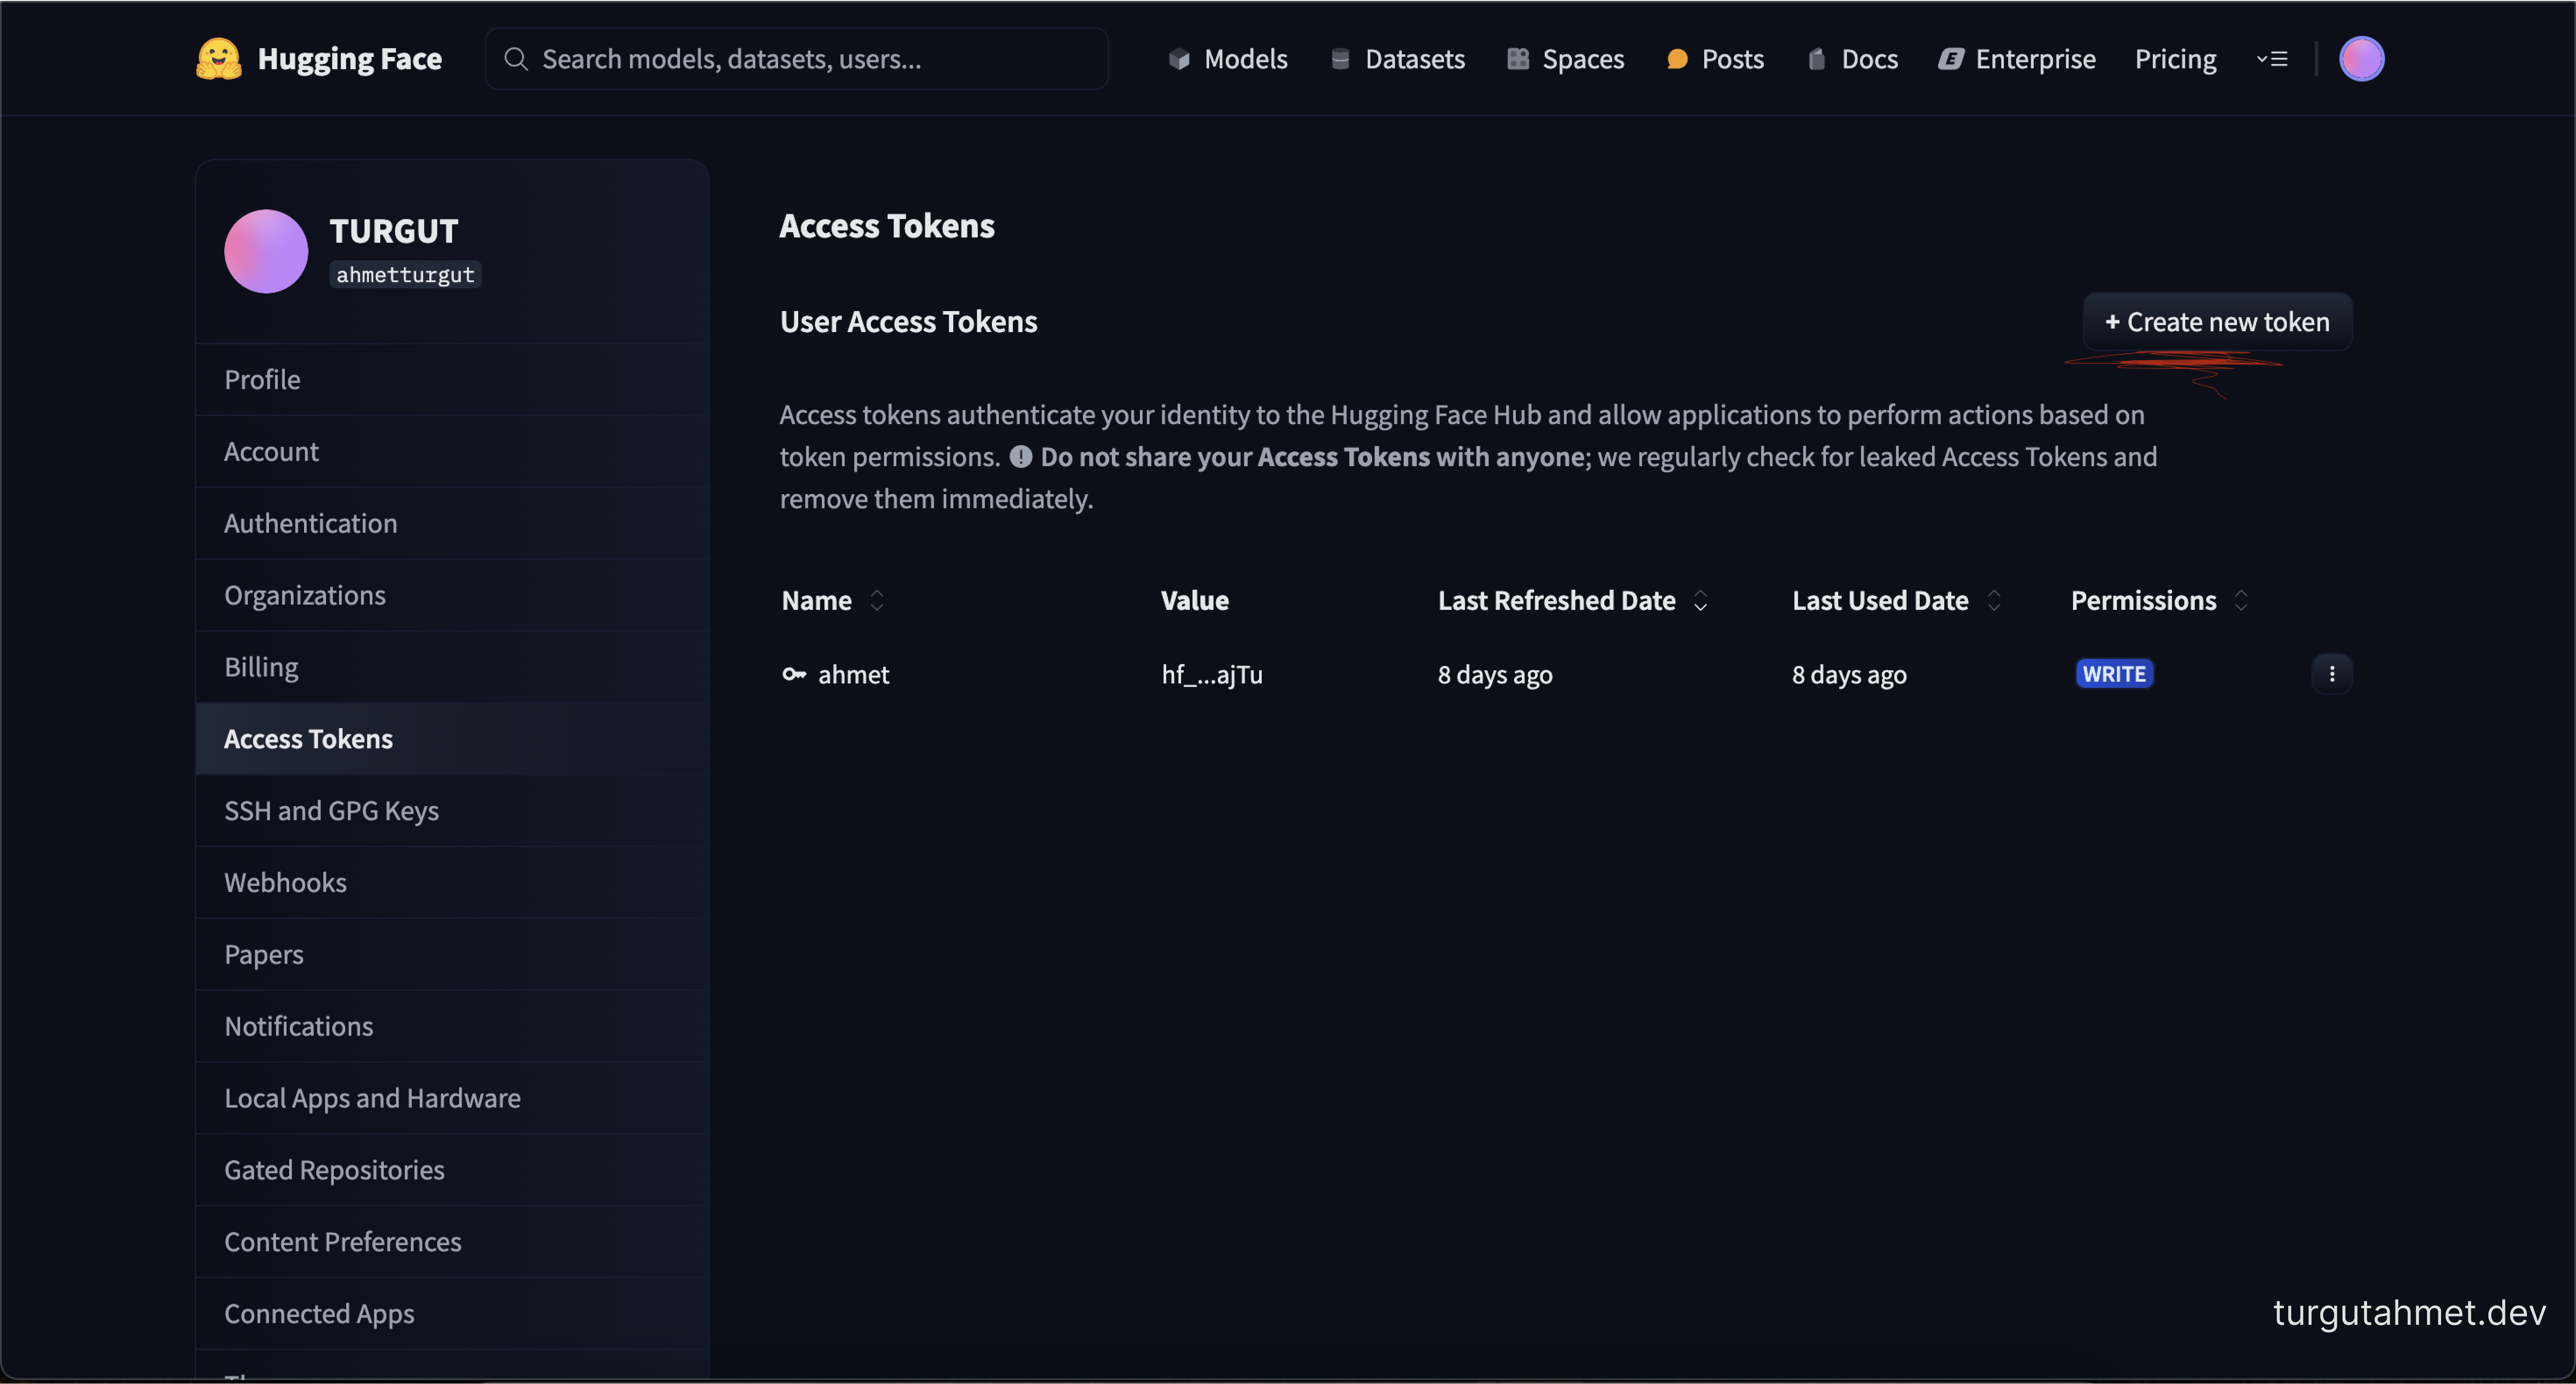
Hugging Face Token Oluşturma:
Google Colab üzerinden fine-tuning işlemini gerçekleştirmek için Hugging Face Access Token'ını gereklidir. Hugging Face üzerinden token oluşturmak için aşağıdaki linki kullanabilirsiniz.
Hugging Face Token Oluşturma
Hugging Face üzerinden oluşturduğunuz dataset ve modeliniz Public olarak paylaşılmış olmalıdır.
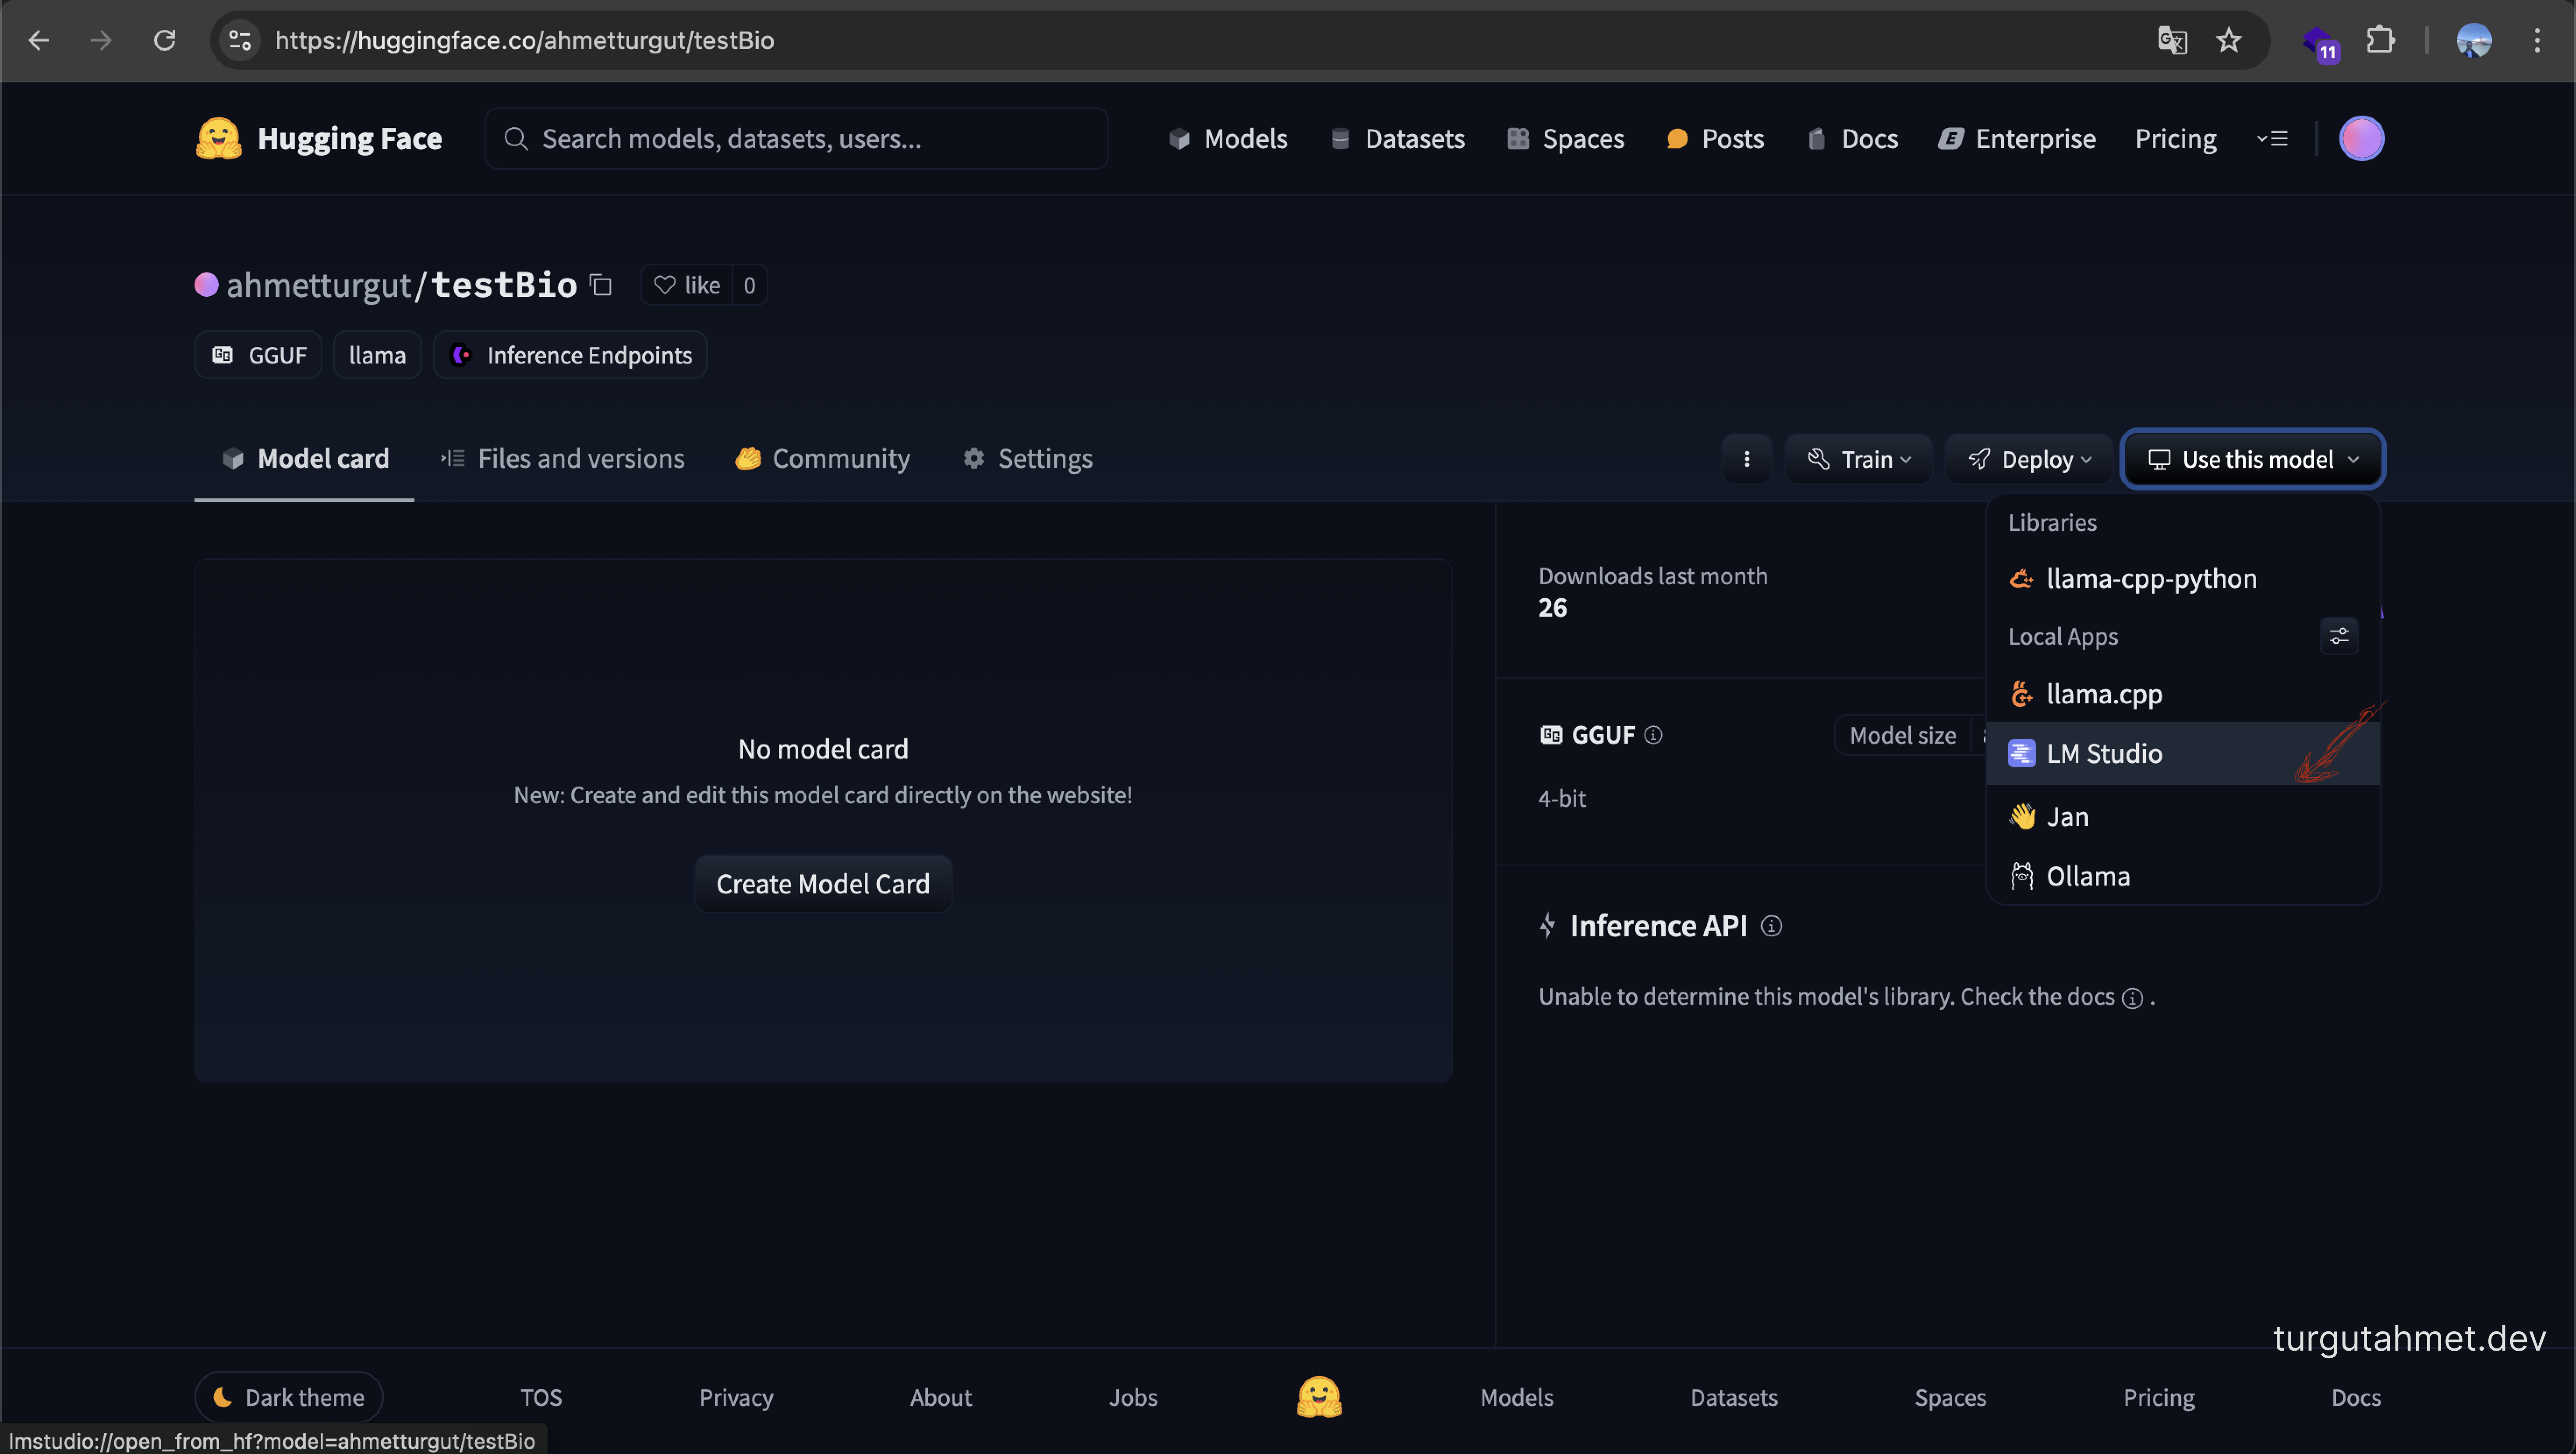
Hugging Face'de Olusturulan Modeli Local'de Çalıştırma:
Hugging Face üzerinden oluşturduğunuz modeli local'de çalıştırmak için aşağıdaki linki kullanabilirsiniz.
LM Studio
Kaynakça:
- Xiao, T., & Zhu, J. (2025). Foundations of Large Language Models. arXiv preprint arXiv:2501.09223.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., ... & Polosukhin, I. (2017). Attention is all you need. In Advances in neural information processing systems (pp. 5998-6008).
- Brown, T., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., ... & Amodei, D. (2020). Language Models are Few-Shot Learners. arXiv preprint arXiv:2005.14165.
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2018). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. arXiv preprint arXiv:1810.04805.
- Wolf, T., Debut, L., Sanh, V., Chaumond, J., Delangue, C., Moi, A., ... & Rush, A. M. (2020). Transformers: State-of-the-Art Natural Language Processing. arXiv preprint arXiv:1910.03771.
- Houlsby, N., Giurgiu, A., Jastrzębski, S., & Ghahramani, Z. (2019). Parameter-efficient transfer learning for NLP.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, L., Wang, S., & Rajkumar, R. (2021). LoRA: Low-Rank Adaptation of Large Language Models.